지난 이야기
1편 – Local LLM 정복하기 – 토큰이 부족해 (1)
2편 – Local LLM 정복하기 – Vector, Embedding (2)
3편 – Local LLM 정복하기 – Embedding (3)
Transformer는 자연어를 처리하여 우리가 묻는 질문에 대해 추론하여 답변을 생성한다. 단어의 의미를 이해했더라도 문장속에서 우리가 무엇을 원하는지 어떻게 알아차릴까?
- Transformer는 우리가 현재 사용하고 있는 Chat GPT, Claude 등 자연어 처리 모델에서 채택하고 있는 구조다.
- 자연어 뿐만 아니라 Vision Transformer와 같은 이미지 처리 등 널리 사용되는 아주 핫한 구조다.
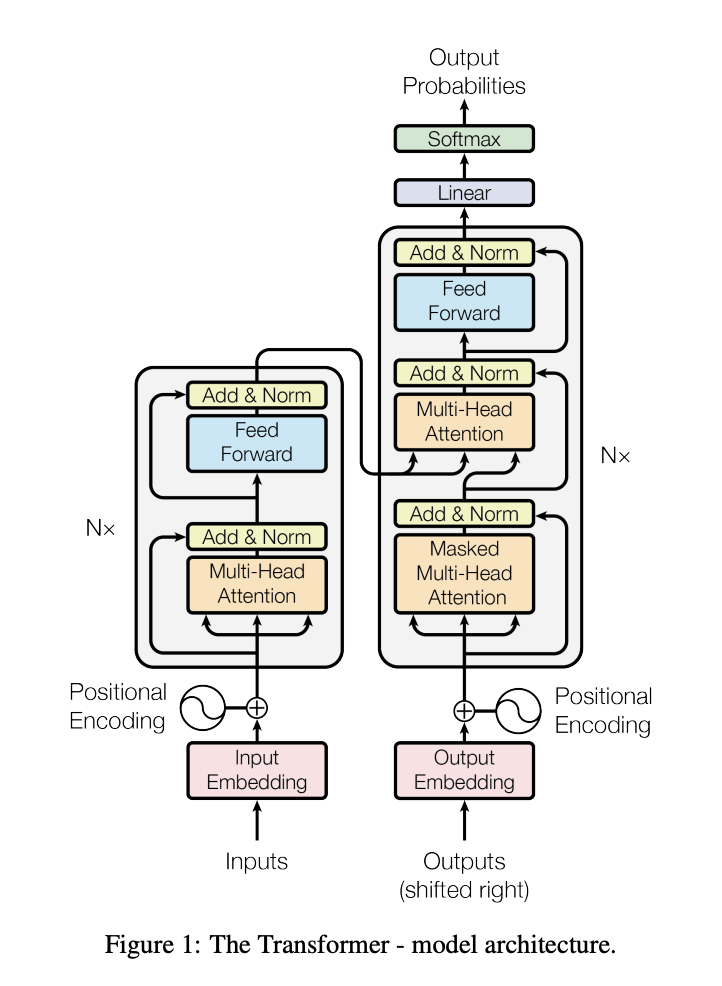
위 사진은 Transformer의 구조를 나타낸 것이고 Input에 대해 Embedding 후에 Positional Encoding을 더하고 있다. 말 그대로 “위치에 대한 인코딩”과 함께 연산하게 되는데 이를 통해 문맥상 단어가 어떤 의미를 갖는지 이해하게 된다.
Positional Encoding, 단어의 순서를 어떻게 알까?
학습을 진행할 때, 그리고 머신은 기본적으로 입력으로 들어오는 문장에서 단어의 순서를 모른다.
쉽게 비유하면, 좋은 아침입니다.라는 문장은 사람은 다음과 같이 받아들인다. 그러나 컴퓨터는 문장을 한번에 통으로 입력받기 때문에, 좋은 아침입니다.를 하나의 뭉텅이로 갖고있다.
graph LR
    Good["좋은"]
    Morning["아침"]
    End["입니다."]

    Good --> Morning --> End

    GoodMorning["좋은 아침입니다."]
그렇다면 Transformer에서 Positional Encoding은 어떻게 동작하는지 다음 두 문장을 통해 알아보자.
철수가 영희를 좋아한다.
영희가 철수를 좋아한다.
두 문장에 등장하는 단어는 동일하다. 그러나 순서에 따라 의미가 달라질 수 있다.
- 철수
- 영희
- 좋아한다.
graph LR
  철수가 --> 영희를 --> Like1["좋아한다"]
  영희가 --> 철수를 --> Like2["좋아한다"]
문장의 의미를 이해하기 위해 Transformer는 Embedding과 Positioanl Encoding을 병렬로 연산하여 더한다.
flowchart LR
    A["Token<br/>철수 · 영희 · 좋아한다"]
    A --> B["Token Embedding"]
    A --> C["Positional Encoding"]
    B --> D["Embedding + Position"]
    C --> D
    D --> E["Transformer 입력"]
    E --> F["Attention"]
    F --> G["Self-Attention"]
이렇듯 위치 정보를 주기 위한 간단한 방법으로 Learnable Positional Encoding이 있다. 학습할 때 시퀀스(문장의 길이)의 각 인덱스에 해당되는 고정 크기의 벡터를 두고 학습시키는 방법이다. 예시로 최대 문장 길이를 4로 설정하여 테이블을 생성했을 경우 4개 이하의 단어가 들어올 때는 학습이 잘 된다. 하지만 실제 우리가 제공하는 문장은 이보다 길 수 있다. 5번째 단어가 들어와 5번째 위치 인덱스(인덱스 4)의 위치 벡터를 조회하려고 하면, 테이블에 정의되지 않은 범위를 참조하게 되므로 index out of range(인덱스 초과) 에러가 발생하게 된다.
graph TD
    subgraph Tokens [토큰 임베딩 시퀀스]
        t0["[ t0 ] <br> Dim=4"]
        t1["[ t1 ] <br> Dim=4"]
        t2["[ t2 ] <br> Dim=4"]
        t3["[ t3 ] <br> Dim=4"]
    end

    subgraph Positions [학습 가능한 위치 임베딩]
        p0["[ p0 ] <br> Dim=4"]
        p1["[ p1 ] <br> Dim=4"]
        p2["[ p2 ] <br> Dim=4"]
        p3["[ p3 ] <br> Dim=4"]
    end

    subgraph Final [최종 입력 벡터]
        f0["[ t0 + p0 ] <br> Dim=4"]
        f1["[ t1 + p1 ] <br> Dim=4"]
        f2["[ t2 + p2 ] <br> Dim=4"]
        f3["[ t3 + p3 ] <br> Dim=4"]
    end

    %% 위치별 1:1 매칭 및 더하기 연산 시각화
    t0 --> f0
    p0 --> f0

    t1 --> f1
    p1 --> f1

    t2 --> f2
    p2 --> f2

    t3 --> f3
    p3 --> f3

    style Positions fill:#f9f,stroke:#333,stroke-width:1px
    style Final fill:#bbf,stroke:#333,stroke-width:2px
잠깐! 헷갈리지 말자. 시퀀스의 길이와 앞에서 배운 임베딩 벡터, 여기서 말하는 벡터 차원은 서로 다르다.
시퀀스의 길이는 토크나이저(Tokenizer)에 의해 쪼개진 토큰의 개수(길이)를 의미하며, 임베딩 벡터는 각 토큰의 의미를 다차원 공간에 표현하기 위해 모델에서 설정하는 차원의 크기다. 즉, 둘의 크기는 서로 아무런 관계가 없다.
이러한 한계를 극복하기 위해 Transformer는 Sinusoidal Positional Encoding을 사용한다. 쉽게 말하면 “Sin-usoidal” Positional Encoding으로 수학의 Sin, Cos의 형태로 Positional Encoding을 수행하는 것이다. 즉 주기 함수를 통해 위치를 계산한다.
주기를 갖는다는 것은 규칙으로 나타낼 수 있다는 것인데, 각 위치의 함수값으로 위치 값을 계산하게 되는데 위에서 설명했던 4차원의 시퀀스를 넘어서는 5차원의 시퀀스가 있더라도 주기함수를 통해 위치 값을 계산할 수 있게 된다.
graph TD
    subgraph Tokens ["토큰 임베딩 시퀀스 (길이 제한 없음)"]
        t0["[ t0 ] <br> Dim=4"]
        t1["[ t1 ] <br> Dim=4"]
        t2["[ t2 ] <br> Dim=4"]
        t3["[ t3 ] <br> Dim=4"]
        t4["[ t4: 새로 유입된 단어 ] <br> Dim=4"]
    end

    subgraph Formula ["Sin/Cos 고정 수식 연산"]
        direction LR
        func["PE(pos, 2i) = sin(...) <br> PE(pos, 2i+1) = cos(...)"]
    end

    subgraph Sinusoidal_Positions ["수식으로 자동 생성된 위치 벡터"]
        p0["[ p0 (고정된 수식 값) ] <br> Dim=4"]
        p1["[ p1 (고정된 수식 값) ] <br> Dim=4"]
        p2["[ p2 (고정된 수식 값) ] <br> Dim=4"]
        p3["[ p3 (고정된 수식 값) ] <br> Dim=4"]
        p4["[ p4: 수식으로 즉시 계산됨 ] <br> Dim=4"]
    end

    subgraph Final ["최종 입력 벡터"]
        f0["[ t0 + p0 ] <br> Dim=4"]
        f1["[ t1 + p1 ] <br> Dim=4"]
        f2["[ t2 + p2 ] <br> Dim=4"]
        f3["[ t3 + p3 ] <br> Dim=4"]
        f4["[ t4 + p4 ] <br> Dim=4"]
    end

    %% 데이터 흐름 및 수식 적용 시각화
    Tokens -.-> Formula
    Formula -.-> Sinusoidal_Positions

    t0 --> f0
    p0 --> f0

    t1 --> f1
    p1 --> f1

    t2 --> f2
    p2 --> f2

    t3 --> f3
    p3 --> f3

    t4 --> f4
    p4 --> f4

    style Formula fill:#fff2cc,stroke:#d6b656,stroke-width:1px
    style Sinusoidal_Positions fill:#e1f5fe,stroke:#0288d1,stroke-width:1px
    style Final fill:#bbf,stroke:#333,stroke-width:2px
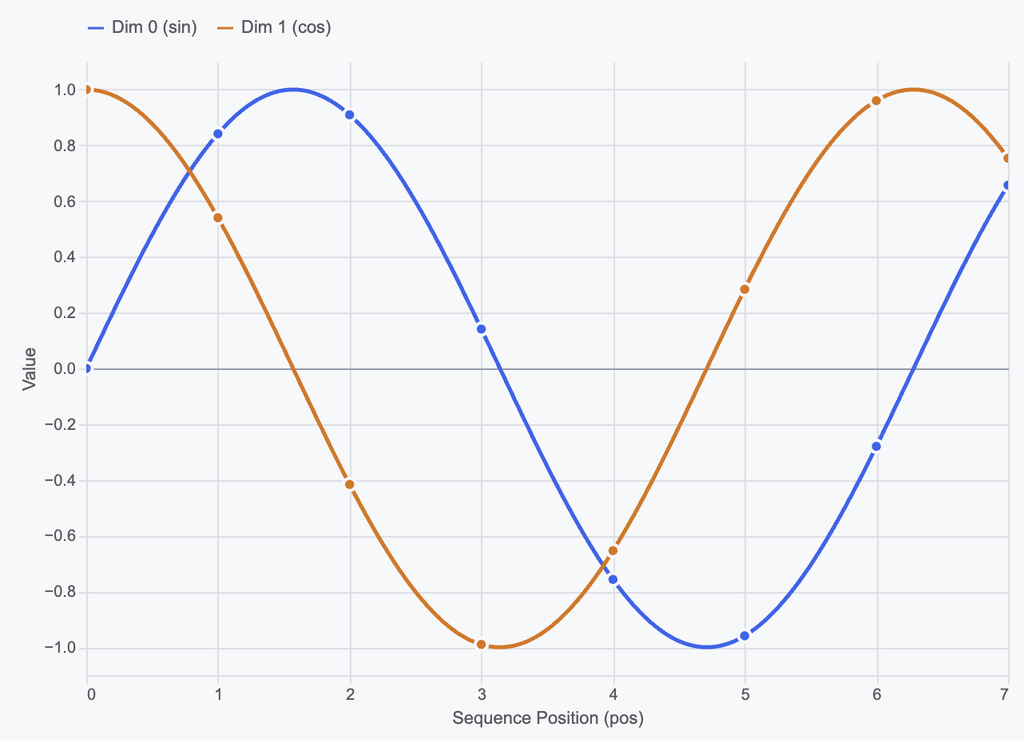
 𝝅)를 바탕으로 설명한 Positional Encoding 값
주기 함수를 사용하면서 새롭게 발생하는 문제점도 존재한다. Sin과 Cos 함수는 [-1, 1] 범위를 반복해서 회전하는 주기함수이기 때문에 단일 차원만 보면 서로 다른 위치임에도 같은 값이 나타나는 모호성이 존재한다.
다차원 조합
모호성 문제를 해결하기 위해서 Transformer는 여러 차원을 함께 사용한다. 다차원의 조합을 통해 모호성을 해결하는 실생활의 대표적인 예로 시계가 있다.
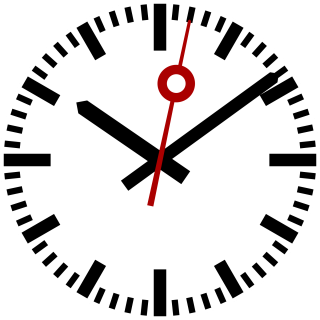
이해를 돕기 위해 시계를 예로 들어보자. 시간은 [ 오전/오후, 시침, 분침, 초침 ]이라는 4차원의 벡터로 표현할 수 있다. 초침 하나만 보면 60초마다 같은 위치로 돌아와 값이 중복되므로, 지금이 몇 시 몇 분인지 알 수 없다. 시침이나 분침도 마찬가지로 단독으로 존재할 때는 값이 겹쳐 모호해진다. 하지만 이 정보들을 하나의 벡터로 결합하면 이야기가 달라진다. 예를 들어 ‘오전 10시 9분 2초’를 뜻하는 [ AM, 10, 9, 2 ]라는 조합은 하루 24시간 중 단 한 번밖에 존재하지 않는 고유한 값이 된다. 트랜스포머의 위치 인코딩 역시 각 차원마다 주기를 다르게 하여 결합함으로써, 시퀀스 내의 모든 위치에 단 하나뿐인 고유한 ‘지문’ 벡터를 부여한다.
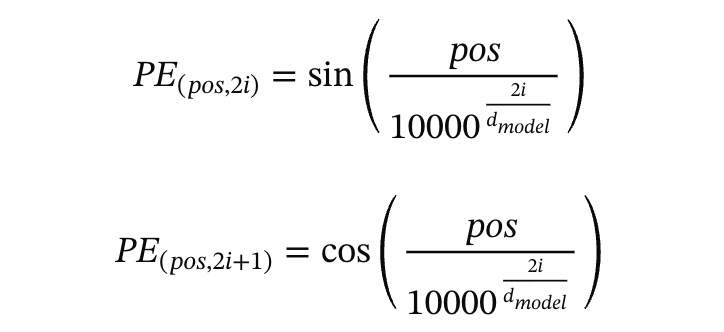
문장 안에서 단어의 위치를 pos, 벡터 내부의 차원 인덱스를 i라고 할 때, 짝수 번째 차원에는 Sin 함수를, 홀수 번째 차원에는 Cos 함수를 번갈아 가며 적용한다. 두려워하지 말고 차근차근 풀어보자. 놀랍게도 복잡해 보이던 위 수식은 연산을 거치면 결국 깔끔한 ‘상수’로 뚝 떨어진다. 고등학교 수학 시간에 배웠던 삼각함수의 덧셈정리 중 하나인 공식을 떠올려보자.
cos(A – B) = cosAcosB + sinAsinB
이 공식이 실제 문장에서 어떤 역할을 하는지 “영희가 철수를 좋아한다.”라는 문장을 예로 들어 살펴보자. 각 단어의 위치를 나누면 다음과 같다.
- t0: 영희
- t1: 가
- t2: 철수
- t3: 를
- t4: 좋아한다.
여기서 모델이 영희와 철수 두 단어의 위치 관계를 파악하는 상황이다. 수식에 의해 두 단어의 위치 벡터는 아래와 같이 계산된다.
영희 = PE(0) = [ cos0, sin0 ] = [ 1, 0 ]
철수 = PE(2) = [ cos2, sin2 ] = [ -0.41, 0.91 ] (계산은 계산기에게 맡기자.)
트랜스포머는 두 단어의 연관성을 파악하기 위해 두 위치 벡터를 내적(Dot Product)한다. 각 성분끼리 곱해서 더해보면 다음과 같은 식이 완성된다.
PE(0) · PE(2) = ( cos(0) * cos(2) ) + ( sin(0) * sin(2) ) = cos(2 – 0) = cos(2) = -0.41
만약에 문장이 “작년부터 영희가 철수를 좋아한다.” 였다 하더라도, “영희”와 “철수”의 위치 관계는 cos(2) = -0.41로 같을것이다.
아니, 당연히 영희와 철수의 글자 위치가 같으니 수학 식으로도 똑같은 값이 나오는거 아니야?
이것이 핵심이다. 우리는 인간이고, 우리가 사용하는 언어이기 때문에 그것을 직관적으로 알 수 있지만, 컴퓨터는 그렇지 않다. 우리는 컴퓨터가 위치를 이해하도록 수학적으로 표현한 것이다. 내적 연산하는 이유는 현재 속도가 가장 빠르고 메모리를 적게 먹는 가성비 최고의 연산이기 때문이다.
차원별 주기를 다르게하여 모호함을 없애자
그렇다면 문장이 아주 길어질 때도 컴퓨터가 이 위치를 구별할 수 있을까? 트랜스포머는 이를 위해 수식에 10_000이라는 상수를 도입하여 차원별로 주기를 다르게 확장했다. 이 설계 덕분에 벡터의 차원들은 저마다 다른 ‘주파수 특성’을 갖게 된다.
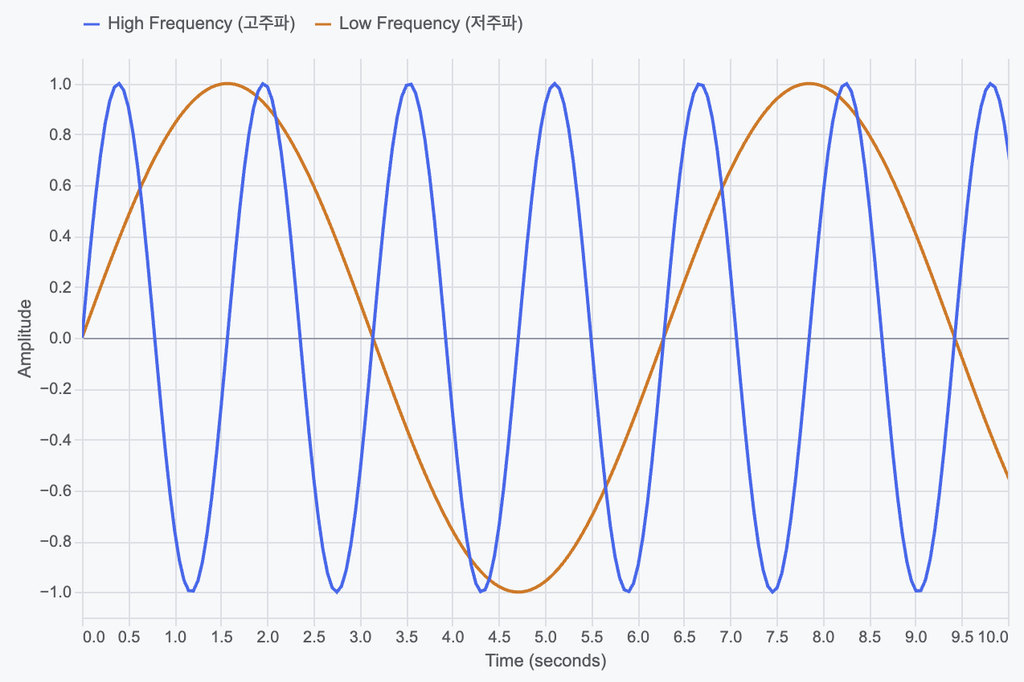
인덱스가 작은 고주파 영역에서는 분모가 작아 파형이 매우 촘촘하고 빠르게 진동한다. 이 영역은 가까운 위치에 있는 단어들 간의 미세한 순서 차이를 정밀하게 잡아내는 역할을 한다. 이는 마치 시계의 초침과 같다.
인덱스가 큰 저주파 영역에서는 분모에 있는 10_000의 거듭제곱 효과로 인해 주기가 기하급수적으로 길어져 매우 완만하게 움직인다. 이 영역은 멀리 떨어진 단어들 간의 대략적인 거시적 관계를 파악하는 역할을 한다. 이는 마치 시계의 시침과 같다.
주파수 성분들이 결합하면서 머신은 문장 안의 그 어떤 단어 조합이든 중복 없이 고유한 Positional Encoding으로 역할할 수 있게 되는 것이다.
다시 식을 보자. 식에서 임베딩 벡터의 인덱스를 보면 i가 커질수록 파장이 길어지는 것을 확인할 수 있다. 그리고 컴퓨터는 단어 하나를 표현하기 위해 이 공식에 존재하는 모든 i값을 빠짐없이 전부 계산하여 벡터를 가득 채운다. 모든 벡터의 모든 차원 자리인 i값에 대해 계산함으로써 임베딩 벡터에 존재하는 다른 단어와의 위치를 계산하고, 추후에 의미를 잃지 않을 수 있기 때문이다.
헷갈리지 말자
분명 “영희가 철수를 좋아한다.” 와 “철수가 영희를 좋아한다.” 는 다른 의미다. 이번 글에서는 이 둘의 의미는 전혀 다루지 않고, 온전히 Positional encoding을 통해 어떻게 단어에 위치 정보를 넣는지만 살펴보았다. 또한 코사인 함수는 수학적으로 방향이 없지만, 사인 함수는 방향을 표현할 수 있다. 그리고 Sinusoidal Positional Encoding은 코사인 함수와 사인 함수를 함께 사용하는 것이다.
- cos(-2) = cos(2)
- sin(-2) = -sin(2)
- 이를 통해 앞 단어와의 관계인지, 뒤에 나오는 단어와의 관계인지 알 수 있다.