지난 이야기
1편 – Local LLM 정복하기 – 토큰이 부족해 (1)
2편 – Local LLM 정복하기 – Vector (2)
Vector를 통해 의미와 관계를 숫자로 표현할 수 있는 공간을 만들고, 학습을 통해 그 공간의 구조를 만들어가는 것을 알았다. 그런데 컴퓨터는 문자를 이해하지 못한다. 애초에 0과 1, 정확히는 전기를 바탕으로 On/Off만 알 수 있다.
우리는 자연어(사람이 사용하는 언어)를 컴퓨터가 이해하도록 변환해야 한다.
Tokenization
문장을 처리하기 위해서 먼저 문장을 Token으로 나누어야 한다. 쉽게 말하면 형태소, 단어 등을 분리하는 작업이다. 즉, 문장을 모델이 처리할 수 있는 단위로 나누는 작업으로, 단어일수도 있고 단어의 일부나 기호일수도 있다.
원숭이는, 원숭이가로 시작하는 문장이 있다면 우리는 두 문장이 다른 의미를 가질것이라고 어렴풋이 생각하는것 처럼, 이를 컴퓨터가 이해하도록 하는 기초 작업이다.
원숭이는 바나나를 좋아한다.
위 문장은 간단하게 [원숭이] [는] [바나나] [를] [좋아한다] [.]로 나눌 수 있다. 실제로 어떤 식으로 토큰화가 되는지는 Tokenizer, 그리고 단어, 언어에 따라 다르게 구성된다.
Embedding
토큰화를 통해 나누어진 단어도 여전히 컴퓨터가 알아들을 수 없다. 또한 인공지능은 행렬 연산을 통해 학습하고 추론하고 이를 위해 우리는 행렬로 단어를 표현해야 한다.
토큰 사전이 다음과 같이 정의되어 있다면, 우리의 문장도 다음과 같이 표현이 가능하다.
원숭이     → 1024
는        → 238
바나나     → 5912
를        → 87
좋아한다    → 7341
.         → 13
[원숭이] [는]  [바나나] [를] [좋아한다] [.]
   ↓     ↓     ↓     ↓      ↓     ↓
[1024] [238] [5912] [87] [7341]  [13]
이러한 숫자를 Token ID라고 하며, 단순히 Tokenizer의 사전에서 해당 토큰을 식별하기 위한 번호이며 무의미하다.
Embedding Vector
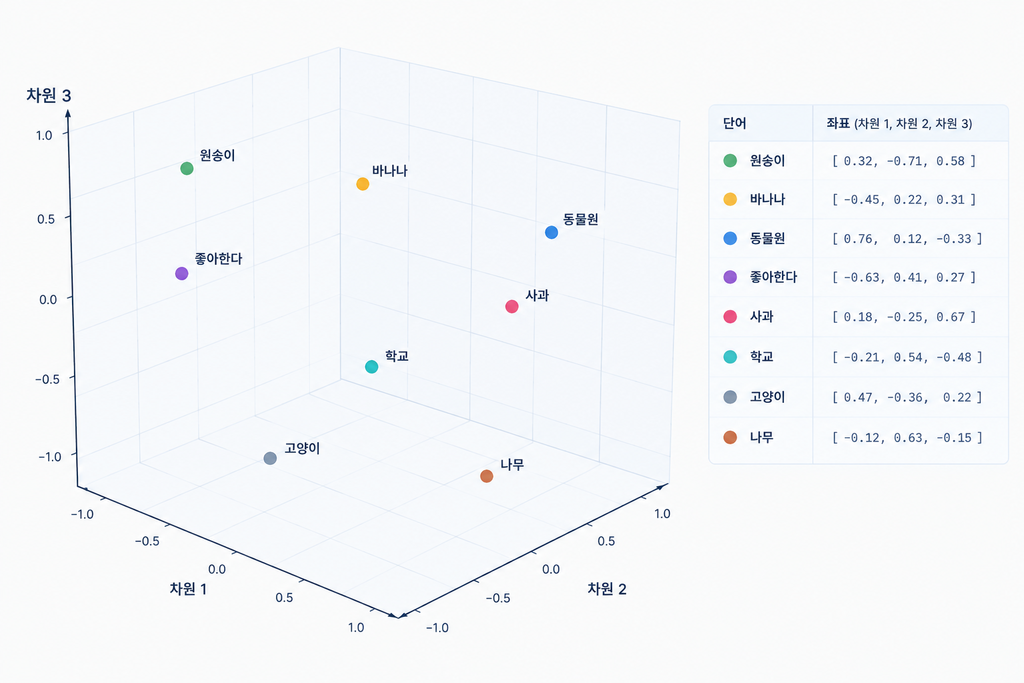
1024라는 숫자가 주어졌을 때 머신은 해당하는 값이 원숭이인지 바나나인지 알 수 없다. 물론 Tokenizer를 통해 “1024 = 원숭이”를 알고 있지만, “원숭이”의 의미를 알고있는 것은 아니다.
원숭이라는 의미를 학습하기 위해 Embedding Vector (Embedding Matrix)를 사용한다. 이 행렬은 처음에 무작위로 초기화되며, 학습을 통해 값이 고정된다. 위에서 사용된 1024라는 Token ID는 이 Embedding Vector중 1024번째 행이 원숭이라는 것을 가리킬 뿐이다.
                  4096차원 (예시)
          ┌─────────────────────────────┐
Token 0.  │  [ ... 4096개의 값 ... ]      │ ← Embedding Vector
Token 1.  │  [ ... 4096개의 값 ... ]      │ ← Embedding Vector
Token 2   │  [ ... 4096개의 값 ... ]      │ ← Embedding Vector
  ...     │             ...             │
Token 1024│  [ ... 4096개의 값 ... ]      │ ← "원숭이"의 Embedding Vector
  ...     │             ...             │
Token N   │  [ ... 4096개의 값 ... ]      │
          └─────────────────────────────┘
학습에 다음의 문장들이 계속 등장한다고 해보자.
- 원숭이가 바나나를 먹는다.
- 원숭이가 나무에 올라간다.
- 동물원에서 원숭이를 보았다.
- 원숭이는 동물이다.
모델은 문장을 예측하는 과정에서 틀린 정도를 계산하고, 이 오차를 바탕으로 임베딩 벡터를 포함하여 수많은 파라미터를 조금씩 수정한다.
최종적으로 학습이 완료되면 인간이 “원숭이”라는 단어를 접했을 때 다른 단어들과 연결해 떠올리는 여러 관계와 맥락처럼 머신도 원숭이라는 단어(토큰)가 다른 단어들(토큰들)과 어떤 관계를 가지는지를 바탕으로 다음 내용을 추론할 수 있게 된다. 즉, 다음과 같은 문장과 선택지가 있다면, 머신은 (ㄴ)을 고를 수 있게 되는 것이다.
"동물원에서 사육사가 먹이를 주자, 나무 위에 있던 ____가 내려왔다."
(ㄱ). 금붕어
(ㄴ). 원숭이
(ㄷ). 토끼