지난 이야기
1편 – Local LLM 정복하기 – 토큰이 부족해 (1)
LLM을 공부하다 보니 모르는 단어가 많다. 특히 현재의 LLM은 Transformer 구조로 되어 있다는데 나는 이 Transformer도 말만 들어봤지 뭔지 모른다.
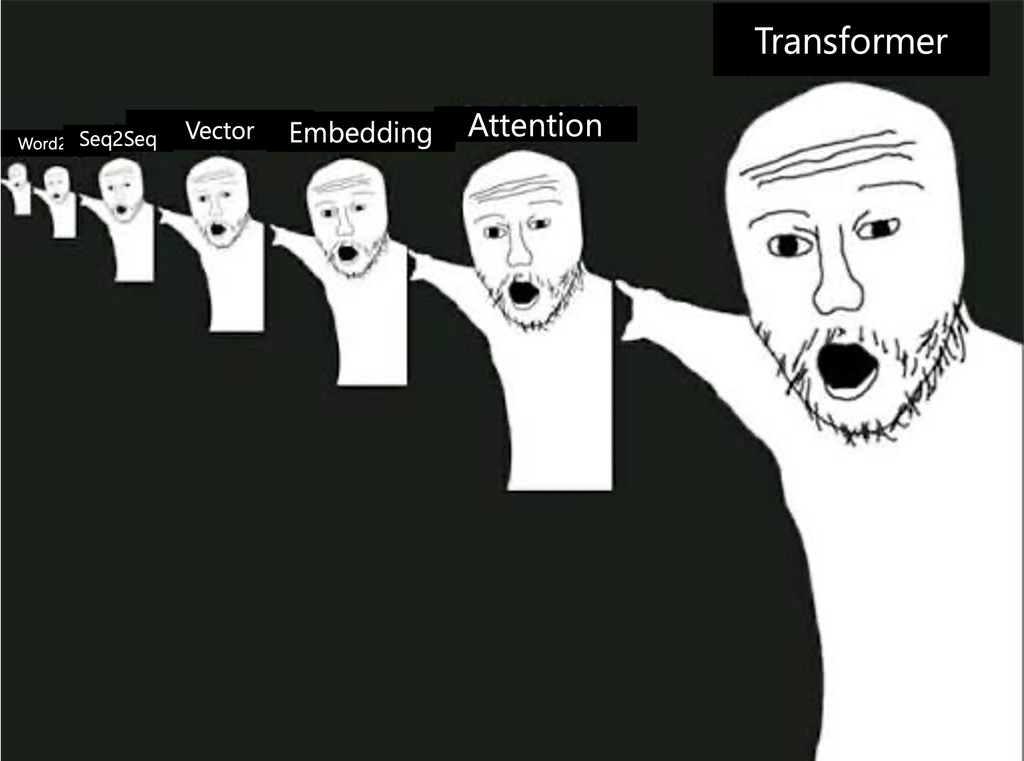
Transformer부터 공부하려고 했더니 Attention이 나오고, Attention을 공부하려 했더니 Embedding이 나온다. Embedding하면 또 Vector가 나온다.
LLM은 Large Language Model이다. 즉, “큰 언어 모델”로 언어를 다룰 수 있는 모델이다. 그렇다면 우리는 어떻게 말을 컴퓨터가 알아들을 수 있게 표현할 수 있을까?
태어난지 얼마 안된 아기들은 부모의 말을 이해하지 못한다. 말을 배우기 시작할 때 부모가 하는 말을 따라할 수는 있지만, 그 말 혹은 단어가 무슨 의미를 갖는지 모르는 채로 따라한다.
그렇다면 의미를 어떻게 컴퓨터가 이해할 수 있을까?
자.. 그럼 시작해볼까..?
Vector
Vector는 쉽게”차원”으로 이해하면 된다. LLM에서 의미를 갖고자 하는 대상인 단어들을 이 차원 위의 좌표로 표현하는 것이다.
상상해보자. 1차원에 수 많은 단어들을 표현한다면 어떻게 해야할까?
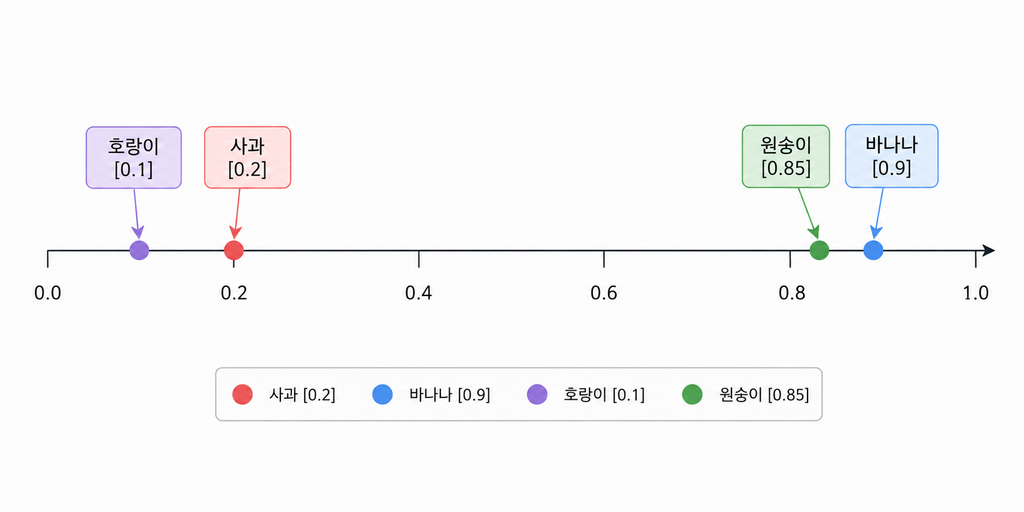
이 상태에서 한 가지 문제가 생긴다.
단어를 단순히 하나의 숫자로 표현한다면, 단어 사이의 의미 관계를 어떻게 표현할 수 있을까?
예를 들어 사과가 0.2, 호랑이가 0.1이라고 했을 때, 두 단어가 수치적으로 가깝다는 사실은 알 수 있다. 하지만 왜 가까운지, 어떤 의미에서 가까운지는 표현할 수 없다.
사과와 바나나는 둘 다 과일이라는 공통점이 있고, 호랑이와 원숭이는 동물이라는 공통점이 있다. 하지만 사과와 호랑이는 서로 다른 의미를 가진다.
따라서 단어를 하나의 숫자만으로 배치하는 대신, 여러 개의 숫자로 구성된 벡터(Vector)로 표현하여 여러 의미적 특성을 하나의 공간에 함께 담을 수 있다.
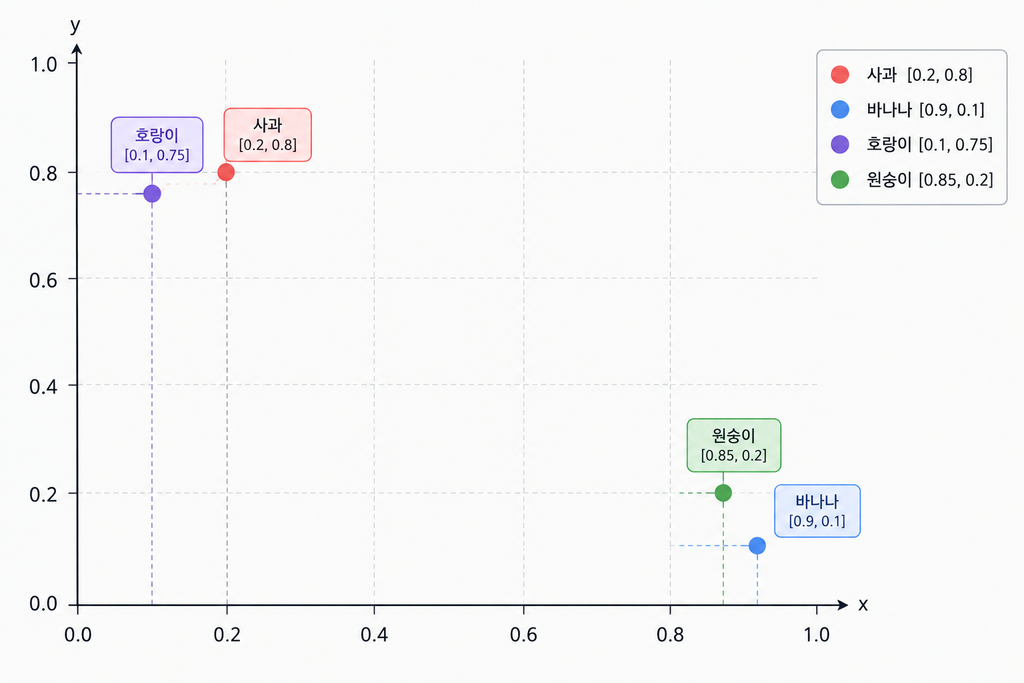
2차원으로 확장해 보면 각 단어를 [x, y]라는 좌표로 표현할 수 있다. 이때 단어들은 하나의 선 위가 아니라 2차원 공간의 한 지점에 위치하게 된다.
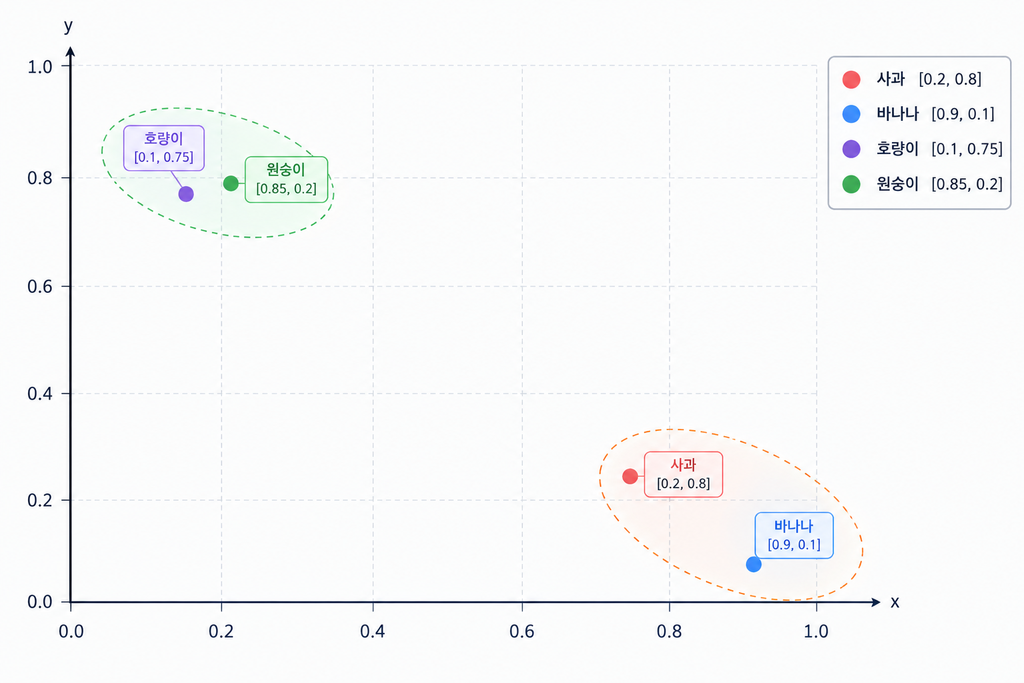
3차원으로 확장하면 기존의 X축과 Y축에 Z축을 하나 더 추가할 수 있다. 이렇게 차원이 늘어나면 단순히 단어의 유사성뿐만 아니라, 단어와 단어 사이의 다양한 의미적 관계를 벡터 공간에 표현할 수 있는 여지가 생긴다.
예를 들어 원숭이와 바나나 사이에는 좋아한다와 같은 관계가 존재할 수 있다. 충분한 데이터를 통해 이러한 관계가 학습된다면, 벡터 공간에서도 두 단어 사이의 관계가 특정한 방향이나 거리의 패턴으로 나타날 수 있다.
즉, 벡터의 차원을 늘린다는 것은 단순히 좌표를 하나 더 추가하는 것이 아니라, 단어가 가진 다양한 의미와 단어 사이의 관계를 더 풍부하게 표현할 수 있는 공간을 만드는 것이다.
그리고 차원을 더 늘리면 100차원, 1,000차원과 같은 N차원 벡터 공간을 만들 수 있다. Transformer는 이러한 벡터 공간에서 단어와 토큰을 수치적으로 표현하고, 학습 과정에서 서로 다른 단어가 어떤 관계를 가지는지를 벡터의 위치와 방향에 반영한다.
즉, 중요한 것은 단순히 단어를 숫자로 바꾼다는 것이 아니다.
의미와 관계를 숫자로 표현할 수 있는 공간을 만들고, 학습을 통해 그 공간의 구조를 만들어가는 것이다.
이처럼 차원이 고차원으로 확장될수록 우리는 단어에 부여할 수 있는 ‘의미의 기준(축)’이 많아지며, 비로소 복잡한 인간의 언어 세계를 반영한 의미별 군집(Cluster)을 완벽하게 형성할 수 있게 된다.
Embedding
| 개념 | 역할 | 비유 | 상태 |
|---|---|---|---|
| 임베딩 벡터 | 단어의 본래 정체성을 담은 고유 좌표 | 사전 속 단어의 기본 정의 | 학습을 통해 값이 고정됨 (문장이 바뀌어도 단어 고유의 시작 값은 같음) |
| 가중치 행렬 (Weight Matrix) | 임베딩 벡터를 Q, K, V로 바꾸는 변환기 | 단어를 상황에 맞게 변장시키는 가면 디자이너 | 학습을 통해 완전히 고정됨 (AI 모델 그 자체) |
| Q, K, V 벡터(Query, Key, Value) | 문맥을 파악하기 위해 임시로 변환된 상태 | 면접이나 대화 상황에 맞춰 변장한 모습 | 문장마다, 위치마다 실시간으로 계속 바뀜 (휘발성 데이터) |
이제 [동물원, 원숭이, 바나나]라는 문장이 Transformer에 들어온다고 생각해보자.
가장 먼저 각 단어는 학습된 임베딩 벡터로 변환된다. 임베딩은 각 단어를 숫자로 변환하는 것이고, 벡터는 단순한 숫자의 나열이 아니라, 단어가 가진 다양한 의미와 특성을 고차원 공간의 좌표로 표현한 것이다.
다시 말하면, 임베딩 벡터는 사전에 학습된 정보를 바탕으로 단어를 고차원 공간의 좌표로 표현한 것이다. 원숭이라는 단어도 하나의 고차원 벡터로 표현되고, 바나나 역시 자신만의 벡터를 갖게 된다.
하지만 Transformer는 이 임베딩 벡터를 그대로 사용하지 않는다. 각 벡터에 학습된 가중치 행렬 W_q, W_k, W_v를 각각 곱해 Query, Key, Value라는 세 가지 벡터로 변환한다.
이 세 가지 벡터는 각각 다른 역할을 한다. Query는 나는 지금 어떤 정보를 참고하고 싶은가?, Key는 나는 어떤 정보를 가지고 있는가?, Value는 실제로 전달할 정보는 무엇인가?라고 생각하면 이해하기 쉽다.
이제 원숭이의 Query와 문장 안에 있는 동물원, 원숭이, 바나나의 Key를 서로 비교한다. 이 비교를 통해 현재 문맥에서 어떤 단어의 정보를 얼마나 참고해야 하는지를 계산한다. 예를 들어 모델이 학습을 통해 원숭이와 바나나가 함께 등장하는 다양한 언어적 패턴을 익혔다면, 특정 문맥에서는 원숭이가 바나나의 정보를 더 많이 참고하도록 높은 Attention 가중치가 만들어질 수 있다.
그리고 이 가중치를 이용해 각 단어의 Value를 섞는다. 바나나의 Value에 높은 가중치가 부여되었다면 바나나가 가진 정보가 원숭이의 새로운 벡터에 더 많이 반영된다. 반대로 관련성이 낮은 단어의 정보는 상대적으로 적게 반영된다.
그 결과 처음에는 단순히 원숭이라는 단어를 표현하던 벡터가 Attention을 거친 뒤에는 현재 문장에서의 원숭이를 표현하는 문맥적 벡터로 바뀐다.
결국 Transformer가 하는 일은 단순히 단어를 숫자로 바꾸는 것이 아니다. 임베딩으로 단어를 벡터 공간에 표현하고, 이를 Q·K·V로 변환한 뒤, Attention을 통해 다른 단어의 정보를 선택적으로 참고하면서 현재 문맥에 맞는 새로운 벡터를 만들어내는 것이다.
그리고 이러한 과정을 여러 층에 걸쳐 반복하면서 모델은 단어 하나의 의미를 넘어, 문장 안에서 단어들이 서로 어떤 관계를 맺고 있는지까지 벡터에 점점 더 풍부하게 반영해 나간다.